Всем привет!
На связи команда разработки UniBPM.
Более десяти лет мы занимаемся автоматизацией бизнес-процессов. Последние восемь – преимущественно при помощи BPMN и Camunda. За это время успели поработать с разными предметными областями, побывать сертифицированным партнёром Camunda и, разумеется, набить собственных BPM-шишек.
В предыдущей статье мы рассказывали, как мы пришли к созданию UniBPM и почему выбор был сделан в пользу собственной разработки.
Сегодня хотелось бы посмотреть на вопрос немного шире:
- что необходимо построить вокруг BPM-движка, чтобы получить полноценное решение?
- какую часть типовой проектной разработки можно превратить в платформенную?
Процесс нарисовали, а в чём работать?
Представим себе вполне типовую задачу: автоматизация согласования закупки.
Аналитик подготовил модель процесса в нотации BPMN => Разработчик реализовал сервисные задачи => Движок: запускает экземпляры процессов, раздаёт задачи пользователям, job worker’ам, дожидается решений согласующих.
В рамках Proof of Concept всё выглядит очень убедительно и принимается решение перейти в фазу пилота.
И здесь начинаются вопросы а ля:
- Где сотрудник создаёт заявку?
- Куда загружается коммерческое предложение?
- Как руководитель видит закупки своего подразделения?
- Кто имеет доступ к договору?
И наш любимый:
- Где искать заявку / договор / согласование после завершения процесса?
И вот в требованиях поселяются карточки клиентов, чек-листы, доски, документы, права доступа, история изменений, интеграции.
Это не недостаток процессного подхода, а следствие того, что исполнение процесса и прикладная система (или системы) вокруг него – это разные вещи.
С этим мы столкнулись в Реюнико: каждый новый проект или новый заказчик влекли за собой необходимость заново разрабатывать вокруг процессов требуемую экосистему.
Так и родился UniBPM: с целью превратить повторяющуюся типовую проектную разработку в функциональные возможности платформы.
Что UniBPM добавляет к процессному движку
Создавая платформу, мы старались не импортозаместить Camunda и прочие BPM-движки, а скорее, восполнить прикладной слой, который процессный движок намеренно не закрывает. По сути, UniBPM – это workflow-платформа поверх BPMN и BPM-движка (или если удобнее – рядом с ними).
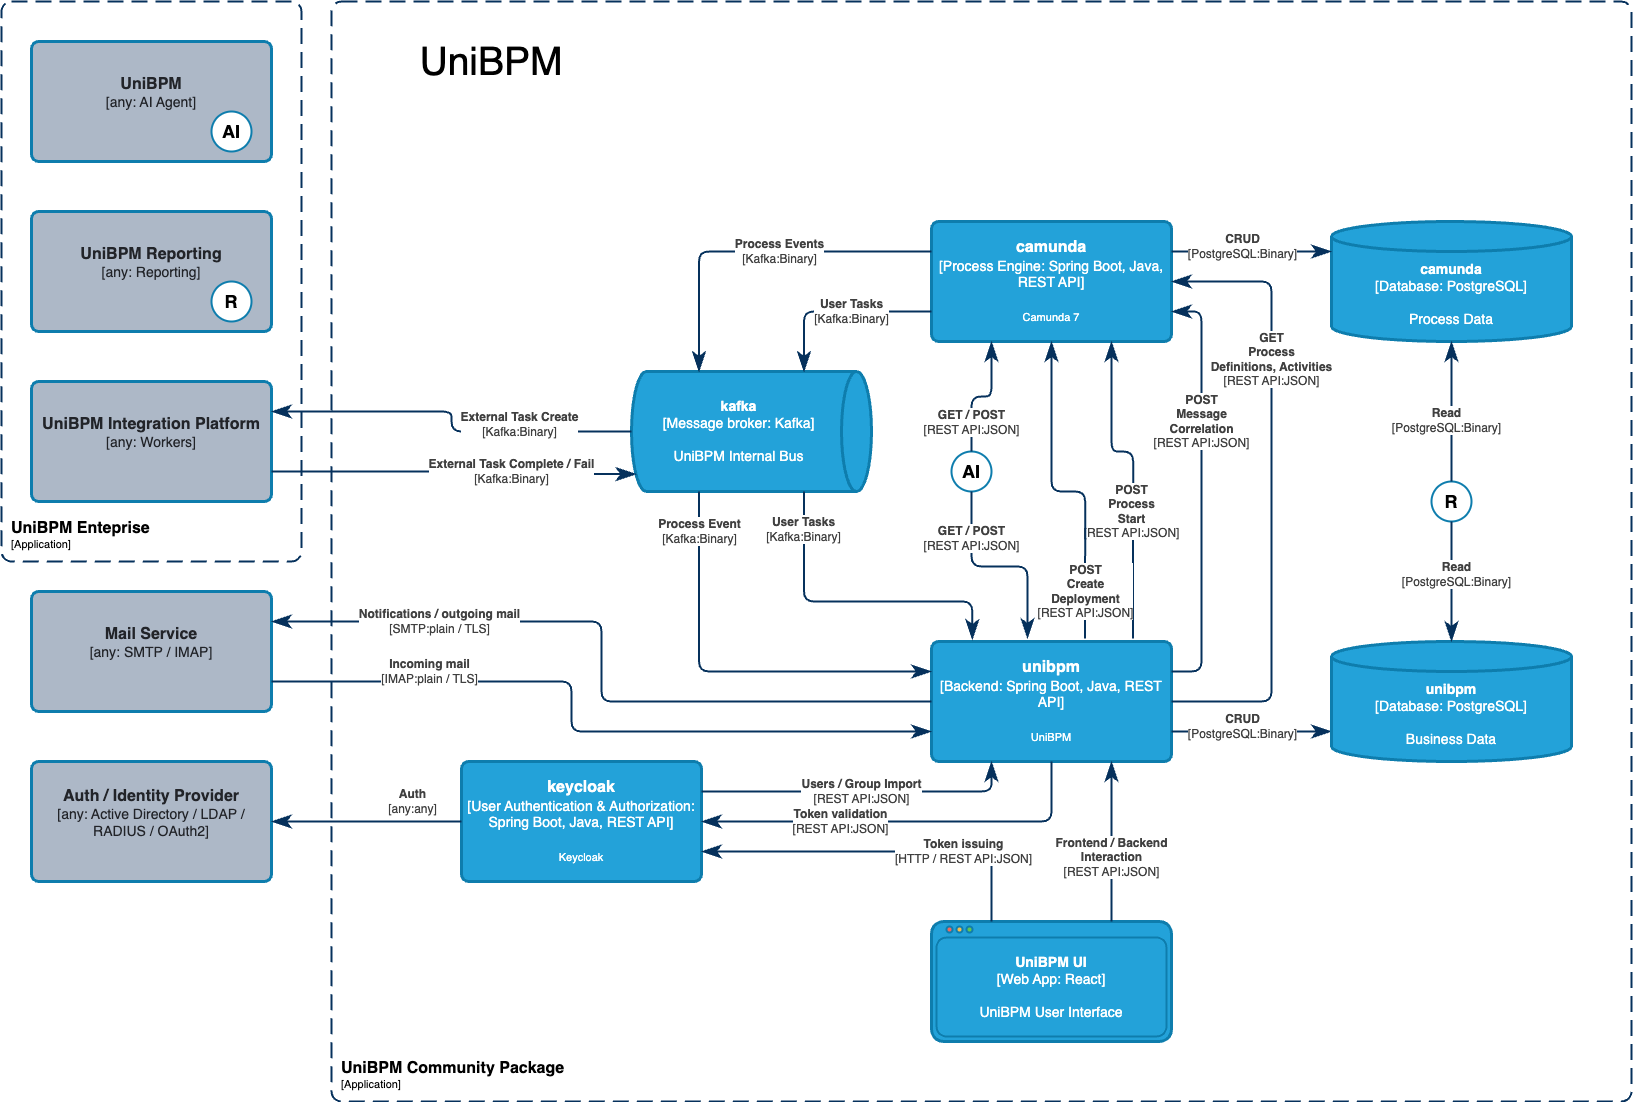
Ниже разберём архитектуру платформы на варианте с UniBPM Engine – процессным компонентом на базе Camunda 7, дополненным механизмами взаимодействия с платформой. Интеграция с Camunda 8 находится в пилотировании и запланирована к выпуску в версии 1.0.7.
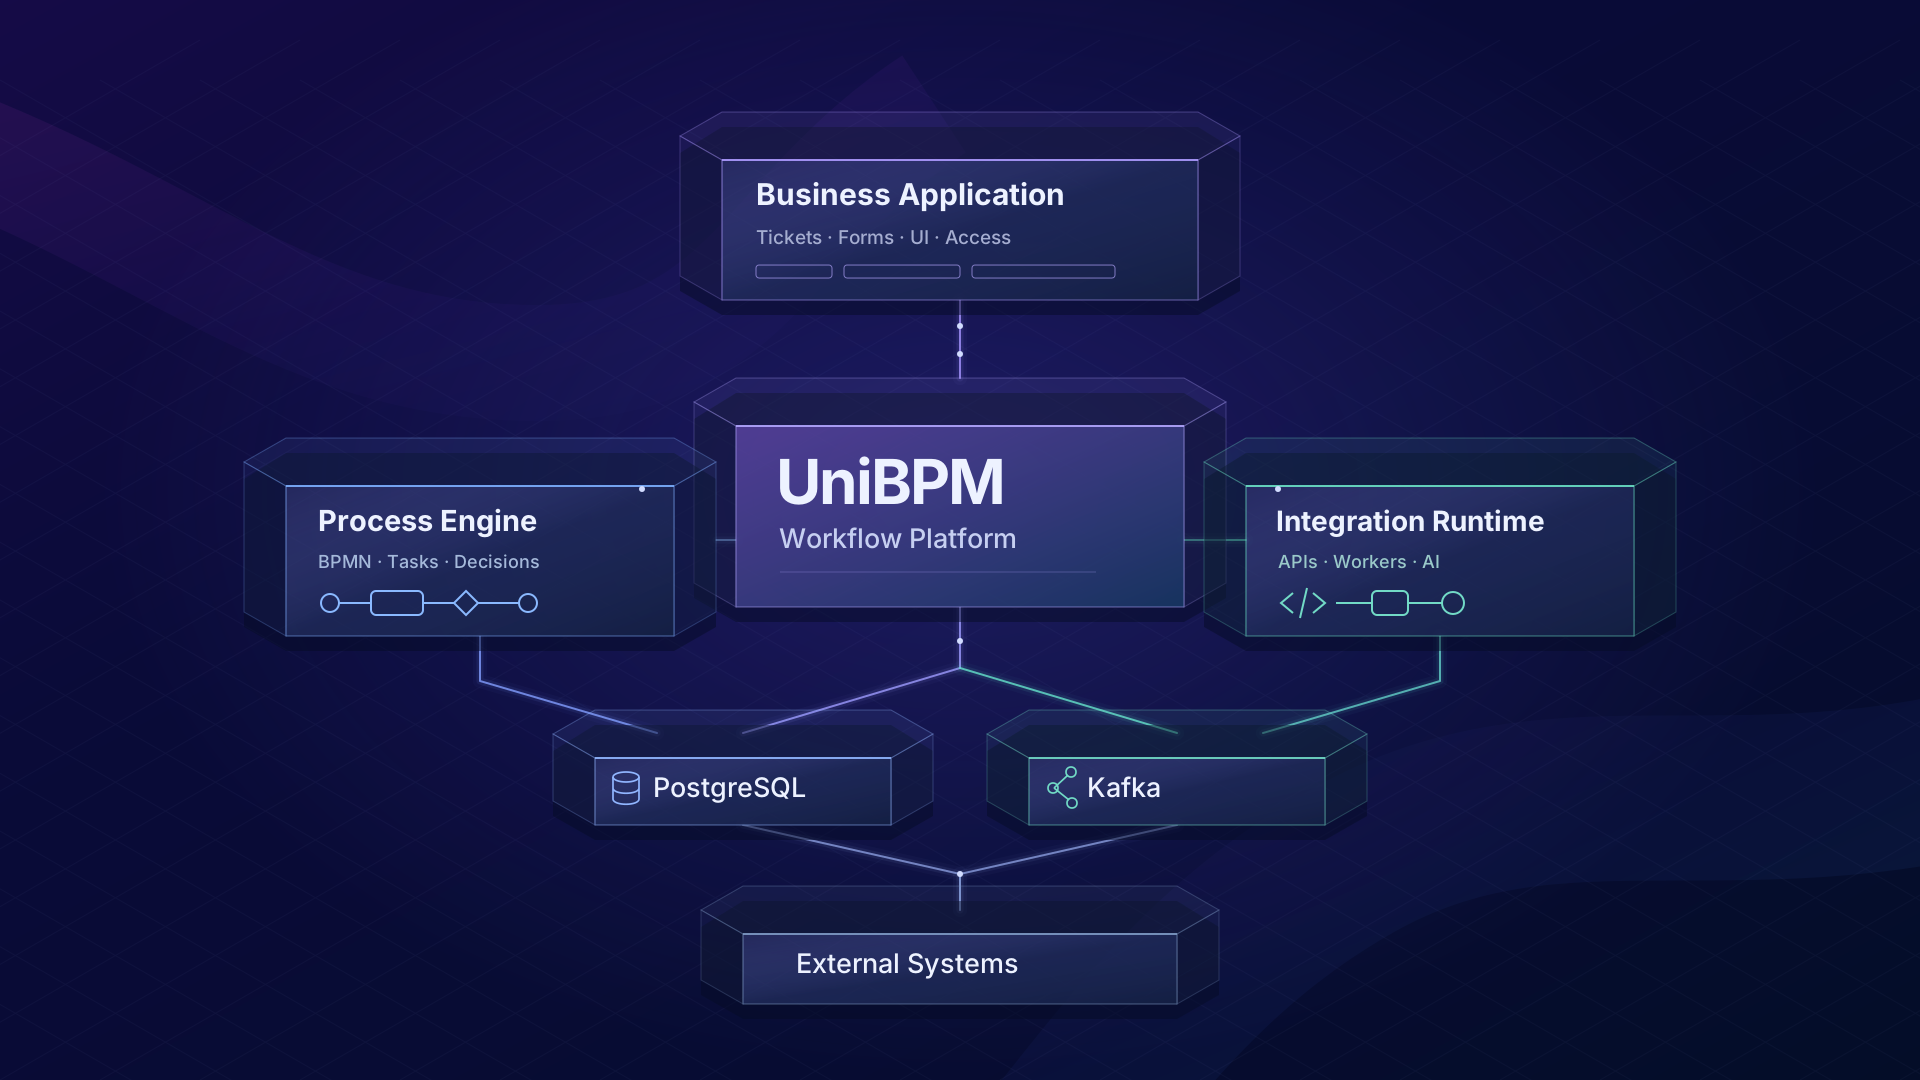
На верхнем уровне у неё три основных компонента:
| Компонент | За что отвечает |
|---|---|
unibpm-app | Бизнес-объекты, прикладные операции, права доступа и API для пользовательского интерфейса. |
unibpm-engine | Исполнение BPMN и DMN, состояние экземпляров процессов, пользовательские и сервисные задачи. |
unibpm-integration-runtime | Обработчики интеграционных задач и взаимодействие с внешними системами. |
Отдельно располагаются frontend на React, Keycloak, Kafka и хранилища PostgreSQL. У бизнес-приложения и движка разделены данные: Business Data и Process Data.
Процесс закончился, бизнес-объект продолжает жить
Если строить приложение исключительно вокруг экземпляра процесса, довольно быстро возникает соблазн сделать его контекст универсальным хранилищем. Сначала кладём в переменные процесса номер договора, затем – идентификатор клиента, потом появляется сумма, результат согласования в JSON и ещё что-нибудь. Чисто на всякий случай.
С одной стороны, это удобно: можно исправить значение через Cockpit, передать данные вызываемому сервису – ведь всё под рукой.
До тех пор, пока не появляется необходимость работать с бизнес-данными помимо процесса.
Центральная сущность UniBPM – Ticket, или Заявка. Название не ограничивает предметную область: это может быть обращение клиента, потребность в сотруднике, договор или запрос на закупку. У заявки есть собственный идентификатор, тип, состояние, владелец, ответственный и связанные данные.
Таким образом, мы разграничиваем ответственность:
- процесс отвечает на вопрос: “Что произойдёт дальше?”,
- а заявка – на вопросы: “С чем мы работаем? Что нам об этом известно? Кто имеет доступ?”.
Каждой заявке соответствует один основной экземпляр процесса; он, в свою очередь, может запускать дочерние процессы. Завершение экземпляра процесса не подразумевает удаления заявки.
Стандартные атрибуты и связи находятся в основной, достаточно разветвлённой и универсальной модели данных. Расширяемая часть хранится в custom fields.
Например, для закупки в этих полях могут находиться сумма и валюта, для кандидата на должность – специализация и грейд.
Это примеры настройки предметной области, а не отдельные жёстко зашитые сущности.
Но здесь есть важная оговорка.
Отделить бизнес-данные от движка – это не значит запретить бизнес-данные в переменных процесса. При необходимости мы можем получить к ним доступ по отдельности, как из процесса, так и из job worker’ов. При этом source of truth для бизнес-объекта остаётся бизнес-приложение, а переменные процесса используются как контекст конкретного исполнения.
Следующий уровень организации данных – Рабочее пространство, Workflow. В терминологии UniBPM это область приложения со своими настройками, типами заявок, артефактами и участниками.
В процессном движке ей соответствует отдельный тенант. В платформе рабочим пространством могут быть, например: проект, бизнес-направление, сервис, продукт, процессная область или подразделение.
Можно выделить отдельные пространства для поддержки, HR и закупок – в каждом будут свои типы объектов, артефакты и правила работы.
Тип заявки (Ticket Type) – позволяет связать бизнес-объект с моделью процесса (BPMN) и экранными формами. При этом сохранение изменённой модели и её развёртывание в движке – разные операции: сохранённый черновик не должен незаметно превращаться в исполняемую версию.
Для команды это означает, что новое прикладное решение можно начинать с настройки пространства, объектов, форм и процесса, а не с очередного проекта “backend + frontend с нуля”.
Но универсальность тоже имеет границы.
Если необходимо реализовать сложную банковскую операцию, расчёт себестоимости или управление складскими остатками, не стоит автоматически переносить всё это в custom fields.
Наша цель – дать общую модель для работы вокруг бизнес-объекта, а не убедить разработчиков, что любая предметная область прекрасно помещается в универсальную карточку.
Пользователям важна работа, а не токен на диаграмме
Для разработчика процесс – это экземпляр, переменные, подписки на события, сервисные и пользовательские задачи. А для сотрудника процесс обычно выглядит как: “согласовать закупку до пятницы”. Поэтому пользователь работает с карточкой заявки, задачами и формами. Информация о пользовательских задачах поступает из движка через Kafka, а выполнение задачи из приложения (или исключение) передаётся обратно в BPM-движок.
Мы продолжаем развивать именно этот прикладной слой. Например, в релизе 1.0.6 переработали страницу задач, добавили представление просроченных задач и счётчики, улучшили фильтрацию и сценарии командной работы. Ещё один интересный механизм, который мы апробировали в одном из проектов, а затем развили в UniBPM: доступные бизнес-действия над бизнес-объектом могут определяться состоянием процесса.
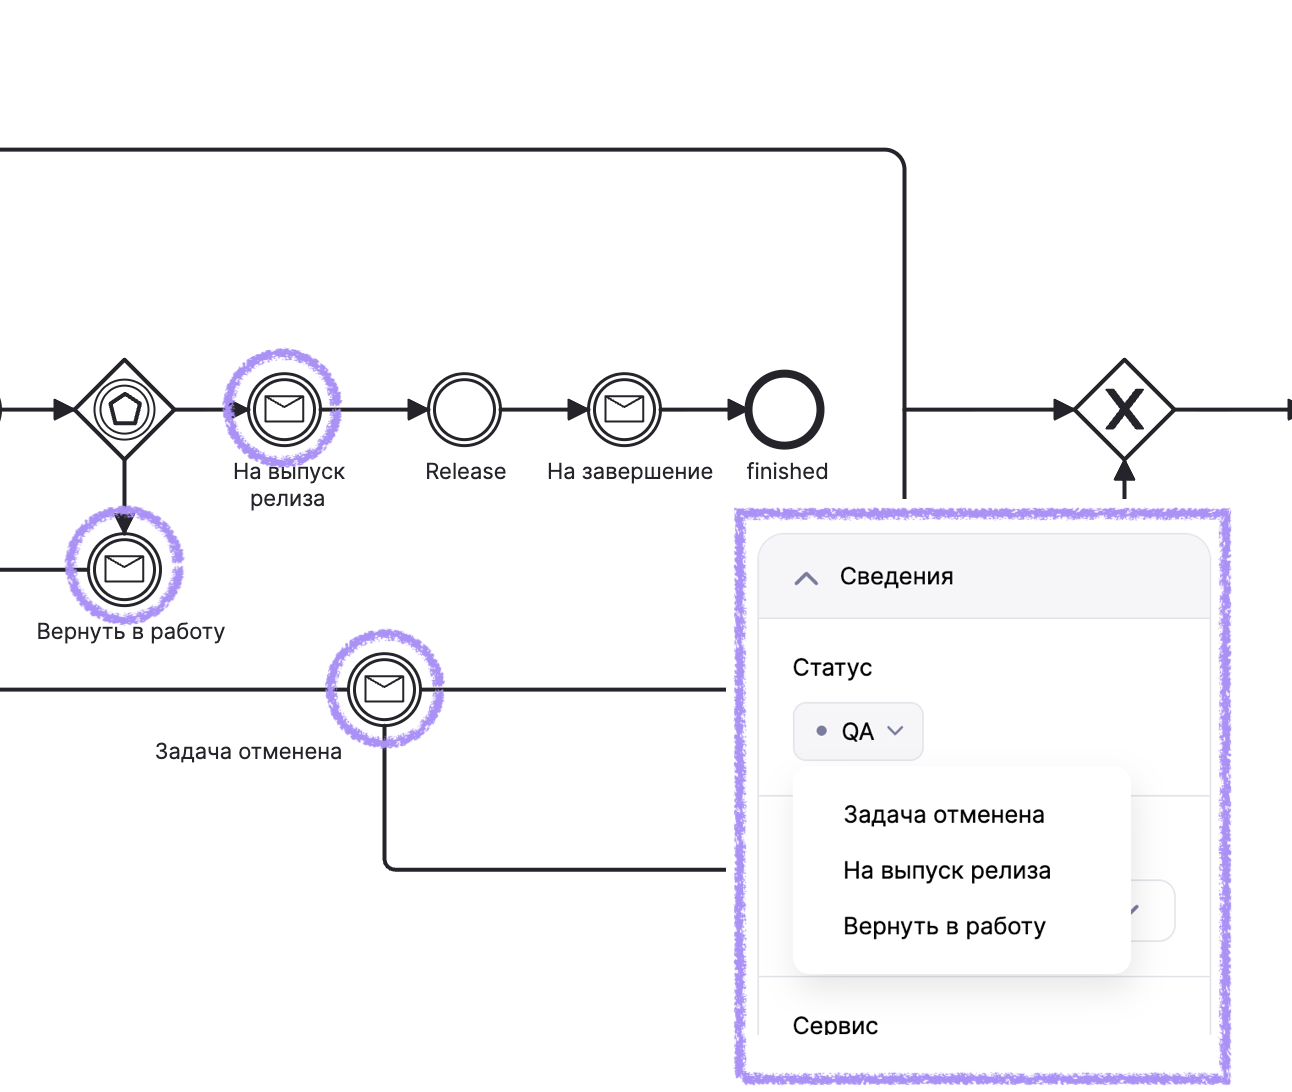
Приложение получает доступные сообщения экземпляра процесса и показывает сопоставленные действия (например, “подтвердить оплату” или “передать на согласование”). При необходимости действие сопровождается формой, после чего в движок передаётся сообщение с входными данными. Такой подход позволяет не моделировать некоторые событийные действия пользователя отдельными User Task и тем самым упростить процесс.
Всё, что происходит между задачами, не остаётся вне системы
Работа редко ограничивается заполнением формы. Участники обсуждают детали, получают письма, прикладывают новую версию документа. Поэтому у заявки есть лента активности, объединяющая комментарии, входящие и исходящие сообщения и события. Вложения встроены в модель приложения и могут быть связаны с разными объектами платформы.
Для внутреннего документооборота предусмотрен механизм подписи вложений с фиксацией подписанта и проверкой целостности. Сразу оговоримся: это не квалифицированная электронная подпись и не обещание заменить любой внешний сервис юридически значимого документооборота.
Смысл всех этих возможностей довольно приземлённый: человеку не должно требоваться пять систем, чтобы выполнить одну задачу.
Откуда берётся состояние заявки
Здесь мы подошли к границе между бизнес-приложением и процессным движком. BPM-движок знает, какие элементы процесса в настоящий момент выполняются. Пользователю же нужно показать понятное бизнес-состояние: “На согласовании”, “Согласовано”, “Отклонено”.
В UniBPM для этого используется сопоставление состояния заявки с элементом BPMN по activityId, пространству и типу заявки.
В частности, точками изменения состояния служат BPMN-события без специального триггера: None Start Event, None Intermediate Throw Event и None End Event. При прохождении соответствующей точки движок передаёт событие, а приложение по businessKey находит заявку и применяет настройку состояния.
Таким образом, не требуется помещать в каждый процесс собственный SQL или Java-код, который знает устройство таблицы заявок.
Движок определяет ход исполнения. Бизнес-приложение хранит состояние объекта и применяет правила его отображения.
Интеграции: не всё нужно делать внутри движка
Один из самых простых способов интегрировать ту же Camunda 7 с внешней системой – вызвать её API из JavaDelegate.
Это удобно для небольшого примера. А в промышленных масштабах нужно внимательнее следить за границами транзакций и работой, выполняемой делегатным кодом.
При синхронном выполнении делегата сетевое ожидание оказывается внутри транзакции движка. Ошибка может привести к откату локальных изменений, но уже выполненное действие во внешней системе от этого не отменится. Асинхронная граница меняет место фиксации состояния, однако сама по себе не делает внешний вызов транзакционным.
Поэтому интеграционные потоки мы выносим в Integration Runtime.
Это отдельное Spring Boot-приложение, состав которого определяется подключёнными модулями. Можно использовать готовые интеграции или добавлять свои. Для сервисных задач применяется механизм External Task. В варианте UniBPM задания и результаты передаются через Kafka: движок публикует задание, runtime выполняет обработчик, результат возвращается в движок. Постоянный REST-polling со стороны обработчика для этого механизма не нужен.
Обработчик определяется тройкой connector / action / version. Например, для документированного коннектора 1С OData фрагмент свойств задачи выглядит так:
<camunda:property name="uni.connector" value="onec-odata"/>
<camunda:property name="uni.action" value="execute"/>
<camunda:property name="uni.version" value="v1"/>
Результат обработчика различает успешное выполнение, бизнес-ошибку и техническую ошибку: COMPLETED, BPMN_ERROR, FAILED. Для технического сбоя предусмотрены параметры повторного выполнения. Собственный обработчик реализуется как Spring Bean с интерфейсом ExternalTaskHandler.
В идеале BPMN описывает, какое действие необходимо выполнить и как поступить с результатом. Интеграционный модуль – как обратиться к конкретной системе. Полностью убрать зависимости невозможно. Но можно сделать их явными и версионируемыми.
А где ИИ?
Там же, где остальные интеграции – в Integration Runtime. Процесс вызывает AI-обработчик через сервисную задачу и получает результат для дальнейшего выполнения.
Но возможность отправить запрос в LLM – не самая интересная функциональность.
Для корпоративного применения важнее другое:
- Откуда модель получает информацию?
- Где хранится инструкция?
- Какие данные ей доступны?
- Что она должна вернуть и в каком виде?
- И кто решает, что делать с результатом?
Поэтому мы рассматриваем ИИ не как нового владельца всей системы, а как участника процесса с конкретной задачей.
Промпт как артефакт пространства
Мы исходим из того, что промпт – это такой же артефакт процесса, как и BPMN- или DMN-модель, шаблон документа или подпись в письме. Его не нужно прятать в Java-коде или поддерживать в отдельном документе.
А изменения в него может вносить пользователь, наделённый полномочиями владельца пространства. При настройке AI-задачи можно указать ключ промпта – ai.in.promptKey, по которому обработчик загрузит инструкцию.
Например, один промпт описывает классификацию обращений, другой – подготовку ответа клиенту. У них разные цели, требования к результату и правила работы с исходными данными.
ИИ получает бизнес-контекст, а не фразу пользователя из чата
У AI-обработчика есть два источника входных данных: переменные процесса и контекст связанной заявки. Источник настраивается для конкретного шага; при отсутствии явного input можно использовать контекст Ticket.
Это важное отличие от сценария, в котором пользователь самостоятельно собирает сведения из нескольких систем и вставляет их в чат.
Например, на первом этапе обработки обращения достаточно понять, о чём написал клиент. На следующем – подготовить ответ с учётом уже выполненных действий и обсуждения со специалистами. Задачи разные, поэтому и набор информации должен отличаться.
Контекст заявки включается через uni.context=true. Можно ограничить число комментариев и вложений; для вложений автоматически передаются метаданные, а получение и подготовка содержимого выполняются отдельно.
Доступность контекста не означает, что модели нужно отправлять всё, что удалось найти.
Если требуется определить категорию обращения, незачем прикладывать к нему всю переписку за полгода. А если необходимо подготовить итоговый ответ, одного первоначального сообщения уже недостаточно. Задача проектировщика – определить необходимый контекст, а не максимально заполнить им запрос.
Разные агенты – разные полномочия
Мы не исходим из того, что в компании должен работать один универсальный ИИ-агент с доступом ко всем данным и операциям. Для разных рабочих пространств и функций можно использовать отдельных агентов. Техническая основа такого разделения – сервисные учётные записи и прикладные права UniBPM: доступ к пространству, чтение, комментирование или изменение заявок.
Например, возможна такая конфигурация: агент классификации читает обращения Service Desk и возвращает категорию; агент подготовки ответа работает с обсуждением заявки; агент HR получает доступ к своему пространству, но не к клиентской переписке.
Причём классификатору необязательно давать право редактировать заявку. Он может вернуть результат процессу, а изменение данных выполнит отдельный предусмотренный шаг.
Если требуется открыть только одну заявку, для сервисного аккаунта можно использовать точечный доступ через TicketPermission, не предоставляя права на всё пространство.
Здесь важно разделять инструкцию и полномочия.
“Не читай кадровые заявки” в промпте – не то же самое, что отсутствие доступа к кадровым заявкам. Два разных промпта, выполняемых под одной административной учётной записью, сами по себе не создают двух изолированных участников.
Таким образом, имеем следующие зоны ответственности:
- промпт определяет задачу,
- полномочия ограничивают доступ к данным и операциям,
- процесс определяет, когда эта задача выполняется и какие последствия может иметь её результат.
Два подхода: извлечь данные и подготовить текст
Для прикладных сценариев мы выделили два основных направления: ai.extract – получение структурированных данных из текста; ai.generate – генерация текста на основе входных данных и инструкции.
Из неструктурированной информации – в структурированную
Представим, что в поддержку пришло сообщение:
После обновления в 1С перестал открываться отчёт по продажам. В саму систему зайти могу, остальные документы открываются.
Человеку смысл понятен. Но для дальнейшей автоматизации хотелось бы получить не ещё один абзац рассуждений, а определённые атрибуты. Например, такой прикладной результат:
{
  "category": "ERP",
  "summary": "После обновления не открывается отчёт по продажам в 1С"
}
Теперь в проектируемом процессе можно проверить категорию и направить обращение нужной команде. Не искать в свободном ответе модели слова “вероятно, это проблема ERP”, а работать с конкретным полем.
При этом ИИ не назначает себе полномочия и не придумывает новый маршрут. Он подготавливает данные, которые использует заранее описанная логика.
Из структурированных данных – в понятный человеку текст
Обратная задача возникает, когда факты уже известны, но их нужно нормально изложить.
Например, специалист устранил проблему и зафиксировал результат. В заявке есть сведения о выполненных действиях и инструкция для пользователя. На их основе можно подготовить черновик ответа.
Здесь роль ai.generate – не самостоятельно определить, устранена ли неисправность, а сформулировать сообщение на основании переданного результата работы.
Аналогично можно проектировать подготовку описаний задач, внутренних пояснений или итоговых резюме.
В одном случае мы превращаем человеческое сообщение в данные для процесса. В другом – данные процесса в сообщение для человека.
Не “ответь как-нибудь”, а результат по контракту
Для ai.extract ожидаемая структура ответа задаётся через JSON Schema – свойство ai.in.schema.
В нашем примере схема могла бы выглядеть так:
{
  "type": "object",
  "properties": {
    "category": {
      "type": "string",
      "enum": ["ACCESS", "ERP", "OTHER"]
    },
    "summary": {
      "type": "string"
    }
  },
  "required": ["category", "summary"],
  "additionalProperties": false
}
Мы описываем обязательные поля, их типы и допустимые значения. В этой схеме неизвестная категория или дополнительное поле будут нарушением контракта.
Почему это важно?
Допустим, модель вернула категорию SOMETHING_WRONG_WITH_ACCOUNTING. Возможно, человеку она даже понятнее. Но в нашей модели процесса такой категории нет.
Для этого примера имеет смысл использовать OTHER и отдельную ветку ручного разбора, а не заставлять модель выбирать неподходящий вариант.
При этом соответствие схеме не означает достоверность ответа. Категория ERP формально допустима, но может оказаться неверной. Схема описывает структуру данных; правильность классификации нужно оценивать отдельно.
Поэтому перед использованием результата необходимы проверки, а в процессе – предусмотренное поведение для ошибок и неоднозначных случаев. Мы не должны превращать любой полученный JSON в безусловное разрешение на дальнейшие действия.
Есть и техническое различие между операциями: в текущем контракте JSON Schema применяется к ai.extract; ai.generate возвращает текст в поле result.text без такой схемы.
То есть структурированный результат извлечения и сгенерированное письмо – не одно и то же, даже если оба передаются приложению в JSON-оболочке.
Пройдём один процесс целиком
Чтобы компоненты не остались набором прямоугольников, вернёмся к упомянутому выше процессу закупки.
Добавим в него работу с коммерческими предложениями: ИИ извлечёт из них данные для сравнения и подготовит краткое резюме для согласующего. Принимать решение о закупке по-прежнему будет человек, а управлять последовательностью действий – процесс. Ниже – пример проектируемого сценария, а не описание готового коробочного модуля закупок.
- Сотрудник создаёт заявку. Заполняет форму, указывает сумму и прикладывает предложения поставщиков. Приложение сохраняет Ticket заданного типа. Для типа заявки сопоставлена BPMN-модель процесса.
- Запускается процесс. Команда запуска попадает в outbox. Фоновый обработчик обращается к движку и сохраняет полученный идентификатор экземпляра. Связь между заявкой и процессом проходит через businessKey, а в пилотной интеграции с Camunda 8 – через переменную ticketId.
- ИИ разбирает коммерческие предложения. Процесс создаёт сервисную задачу для
ai.extract, которую выполняет Integration Runtime. Обработчик получает промпт из UniBPM, необходимые данные заявки и процесса, а также подготовленный текст предложений. Получение содержимого вложений и извлечение текста из используемых форматов предусматриваем отдельным интеграционным шагом: наличие файла у заявки ещё не означает, что его содержимое автоматически попало в запрос к модели. Ожидаемый результат описываем JSON Schema: поставщик, состав предложения, сумма, валюта, сроки поставки и условия оплаты. Если сведений нет, модель должна обозначить их отсутствие, а не додумывать за поставщика. - Проверяем результат извлечения. Следующий шаг проверяет соответствие схеме и предусмотренные бизнес-условия. Например, заполнены ли обязательные сведения и совпадает ли сумма выбранного предложения с суммой заявки. Если информация отсутствует или обнаружены расхождения, процесс создаёт задачу на уточнение. Полученный от модели JSON не становится основанием для закупки только потому, что его удалось разобрать.
- ИИ готовит резюме для согласующего. Проверенные структурированные данные передаются в
ai.generateвместе с отдельным промптом. На их основе модель составляет краткое сравнение предложений: чем отличаются стоимость, сроки и условия оплаты, на что стоит обратить внимание. Получается обратное преобразование – из данных в понятный человеку текст. В этом сценарии AI-обработчикам достаточно прав на чтение необходимых данных; результаты они возвращают процессу. Давать им возможность самостоятельно согласовывать заявку или создавать заказ в ERP незачем. - Руководитель получает задачу. Движок создаёт
User Task, информация о ней поступает в приложение. Руководитель видит заявку, исходные предложения и подготовленное резюме. Он может проверить выводы по документам и принимает решение в форме задачи. Команда завершения возвращается в движок. ИИ помогает быстрее разобраться в материалах, но не подменяет согласующего. - Процесс выбирает дальнейший маршрут. Например, закупка определённого оборудования требует дополнительного согласования с ИТ или информационной безопасностью. Маршрут определяется правилами процесса на основании проверенных атрибутов и решений участников, а не свободным советом модели. Это правило нашей условной BPMN-модели, а не условие, зашитое в карточку заявки.
- Интеграционный обработчик создаёт документ во внешней системе. После необходимых согласований процесс передаёт задание обработчику ERP. Его контракт и соответствие полей нужно настроить под конкретную систему. Для создания документа используются согласованные данные, а не текст резюме, подготовленного ИИ. Результат возвращается в процесс, который либо продолжает работу, либо обрабатывает предусмотренную ошибку.
- Приложение получает новое бизнес-состояние. При прохождении настроенных точек BPMN заявка переходит в соответствующие статусы. Документы и обсуждение остаются у бизнес-объекта и доступны после завершения процесса.
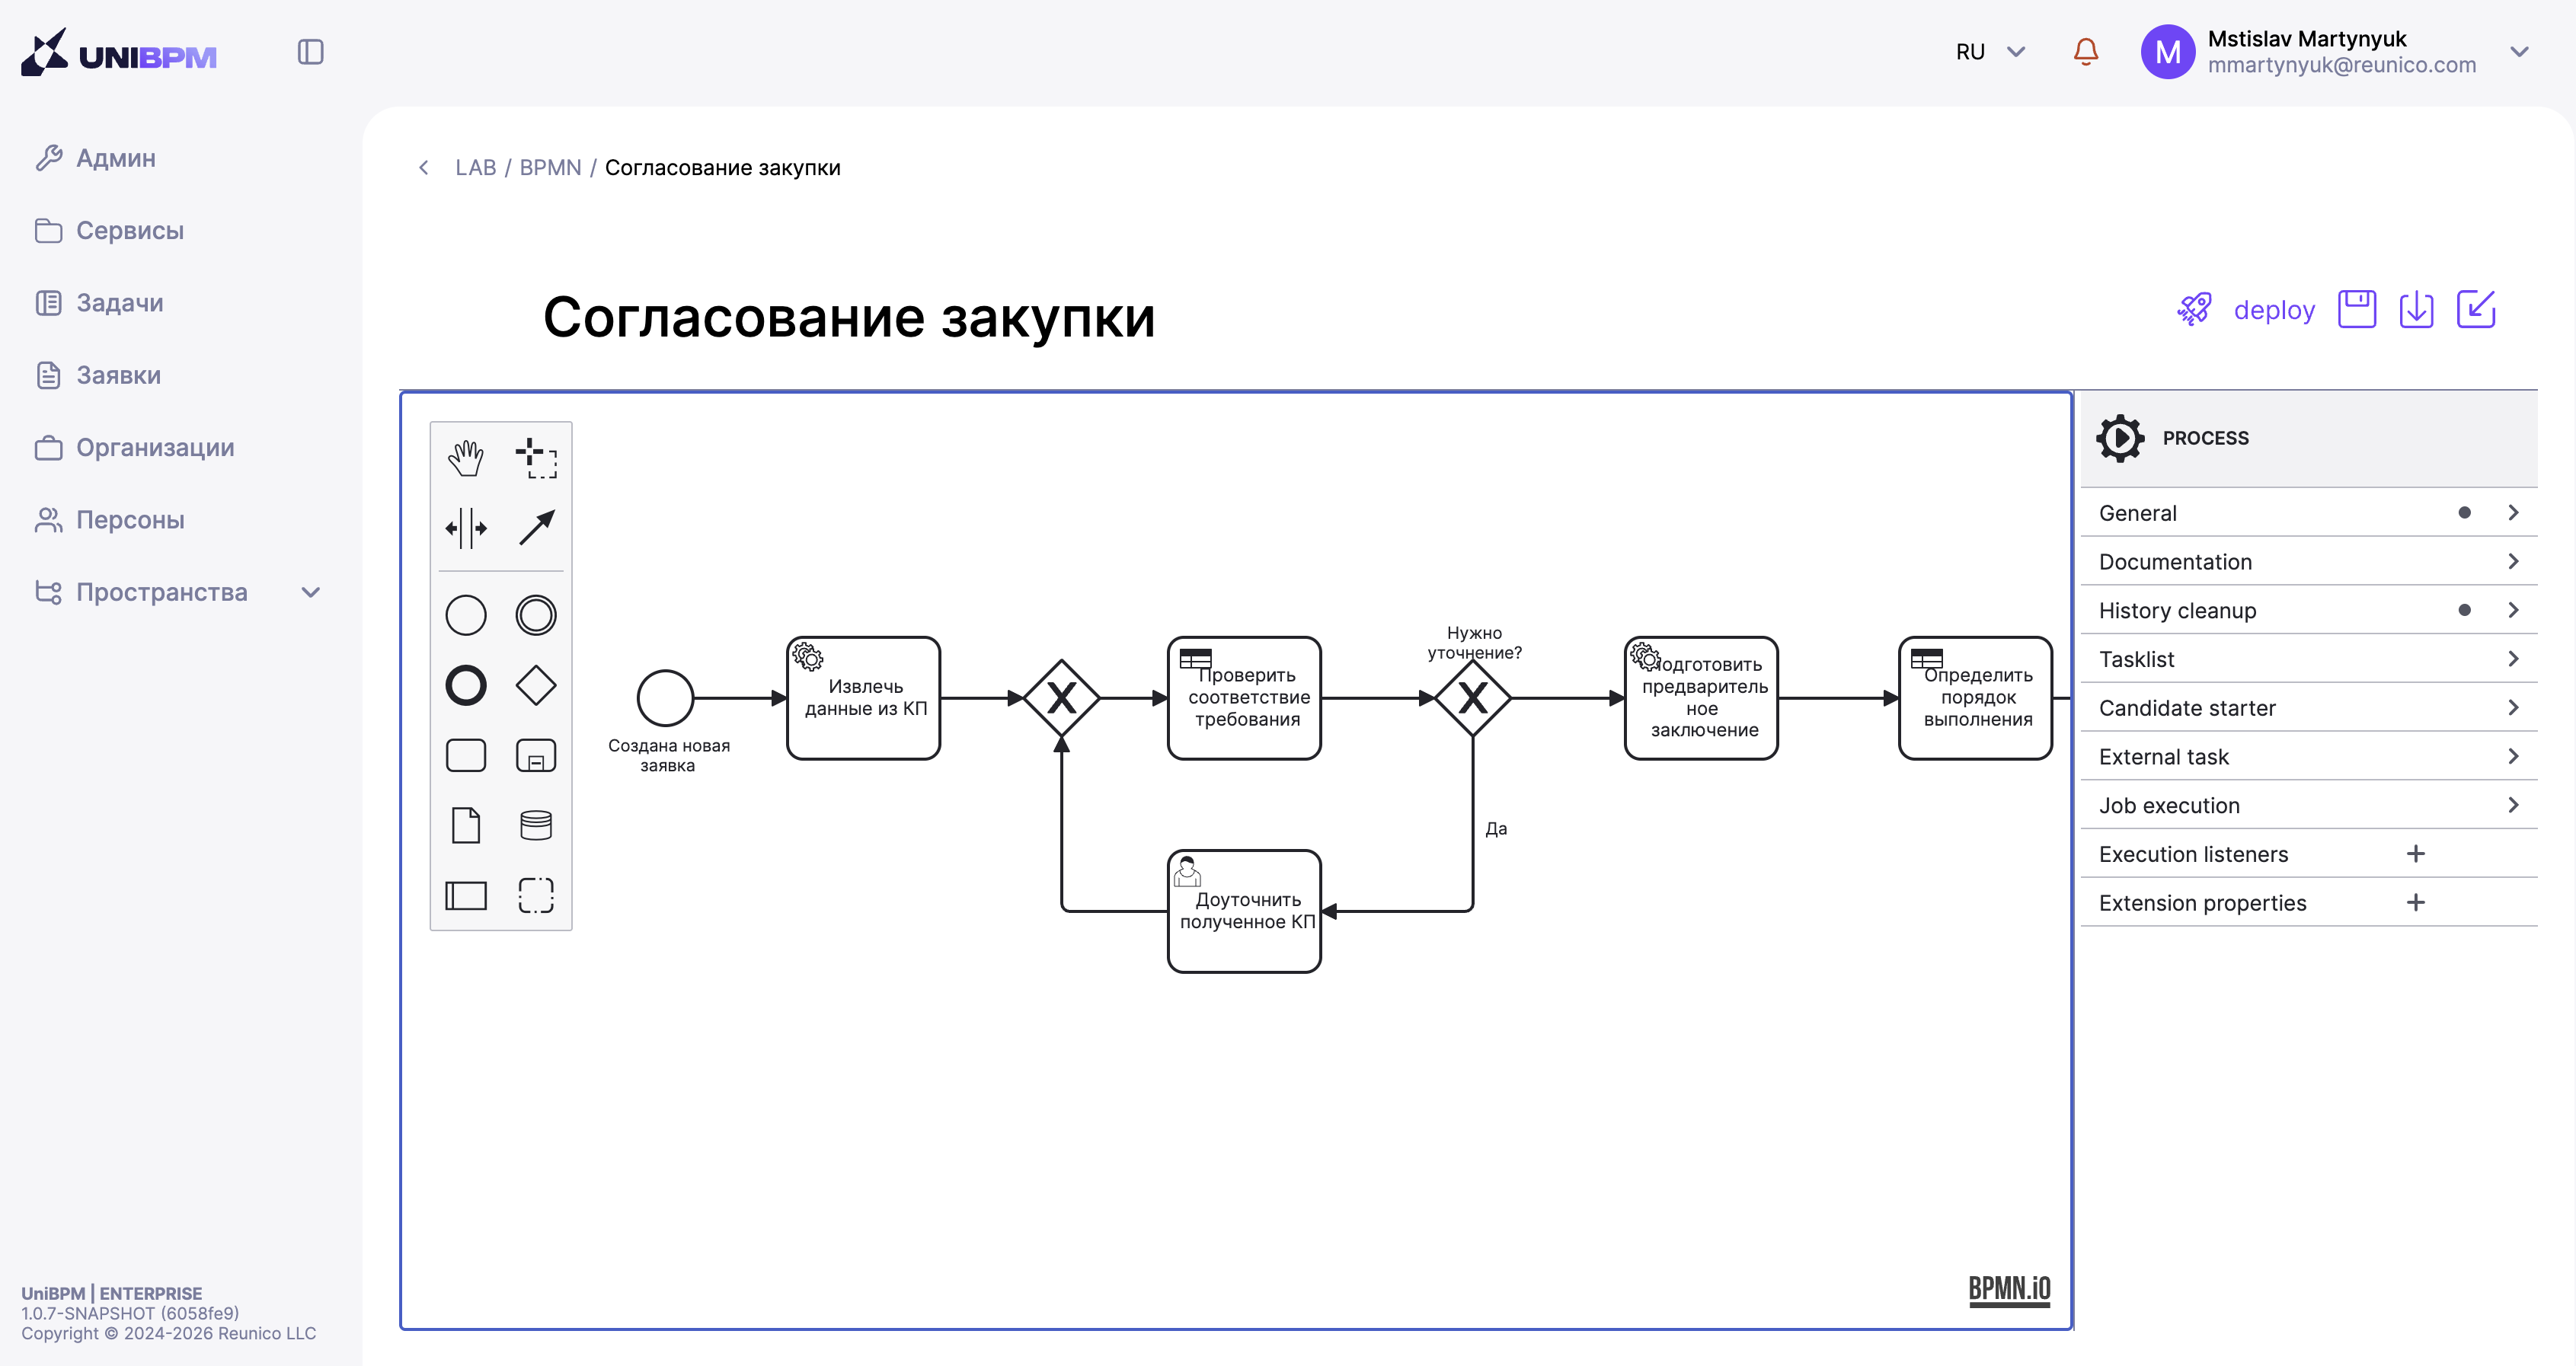
Таким образом, мы видим чёткое разделение зон ответственности:
- ИИ извлекает информацию и помогает её изложить;
- человек через UI принимает решение;
- процесс определяет последовательность действий;
- интеграционные обработчики выполняют операции во внешних системах.
Ролевая модель – кто и за что отвечает
В UniBPM предусмотрено пять категорий пользователей:
- Пользователь – выполняет назначенные ему задачи и работает с заявками, где указан владельцем или ответственным.
- Участник пространства – получает доступ к заявкам пространства: чтение, комментирование или изменение — в зависимости от выданных прав.
- Участник заявки – получает через
TicketPermissionдоступ к конкретной заявке, без доступа ко всему пространству. - Владелец пространства – управляет его участниками и настройками: моделями процессов, формами, шаблонами и уведомлениями.
- Администратор системы – имеет полный доступ ко всем пространствам, заявкам и системным настройкам.
На уровне Заявки распределение ответственности соответствует следующим ролям матрицы RACI:
| Поле или механизм UniBPM | Роль RACI | Назначение |
|---|---|---|
owner — владелец заявки | Accountable | Отвечает за конечный результат |
responsible — ответственный | Responsible | Отвечает за выполнение работы |
Остальные участники через TicketPermission | Informed | Получают доступ к информации по заявке |
При этом роль в распределении ответственности и технические права доступа – разные характеристики. Для участника заявки TicketPermission может разрешать чтение (READ), комментирование (COMMENT) или редактирование (EDIT).
Такое сопоставление охватывает A, R и I. Отдельная роль Consulted в этой схеме не выделена.
Безопасность не заканчивается входом через Keycloak
Аутентифицировать пользователя – это только начало. После этого нужно определить, какие заявки, документы и действия ему доступны.
Разграничение доступа в UniBPM осуществляется применением ролей (Role) и групп (Group).
- Роли – используются для определения отношения пользователя к системе: администратор, обычный пользователь, пользователь с ограниченным доступом к REST API или UI.
- Группы – применяются для функционального объединения пользователей: Финансы, Закупки, HR, Согласующие лица и т.д. Группам предоставляется доступ к рабочим пространствам и задачам.
Управление ролями и группами осуществляется через Keycloak.
Членами групп и носителями ролей могут быть как обычные пользователи, так и сервисные учётные записи.
Для удобства использования выполняется периодическая синхронизация групп и пользователей из Keycloak во внутреннюю базу UniBPM. Кроме того, в релизе 1.0.4 появился JIT provisioning: пользователь и его членство в группах синхронизируются при входе в систему.
Доступ к пространству и доступ к отдельной заявке – разные механизмы.
Для точечной выдачи используется TicketPermission: можно предоставить права пользователю, группе или сервисному аккаунту, не открывая остальные заявки пространства.
Предусмотрены уровни чтения, комментирования и редактирования.
Это позволяет, например, привлечь специалиста к конкретному обращению без выдачи доступа ко всей очереди.
Также, есть возможность скрыть отдельные элементы UI для заданных ролей при помощи правил видимости (UiAccessRules). Правила видимости управляют представлением интерфейса и не заменяют проверку доступа к данным и операциям на сервере!
Что под капотом?
Технологический стек намеренно привычный: Java, Spring Boot, React, PostgreSQL, Kafka и Keycloak. Для знакомства с платформой есть Community Installer на Docker Compose. Он позволяет развернуть основные компоненты в виде песочницы, без самостоятельной сборки всей инфраструктуры. Компоненты платформы развёртываются отдельно, поэтому пользовательскую, процессную и интеграционную нагрузку можно масштабировать независимо. При запуске нескольких экземпляров необходимо учитывать координацию фоновых заданий, обработку сообщений, WebSocket-соединения и нагрузку на общие хранилища. Конкретная конфигурация проверяется под профиль нагрузки заказчика. Integration Runtime необязательно разворачивать как один большой сервис, содержащий все интеграции компании. Это модульное приложение: его функциональность определяется подключёнными зависимостями, а интеграционные модули используют общую инфраструктуру runtime.
Отсюда и возможность формировать отдельные развёртывания под разные задачи.
Например, во внутреннем контуре разместим runtime с модулями взаимодействия с 1С, ERP и другими корпоративными системами. В DMZ – отдельный runtime с модулями приёма запросов от внешних систем. Зачем сервису, принимающему обращения с публичного сайта, одновременно содержать интеграцию с бухгалтерией? В такой схеме для каждого развёртывания мы определяем необходимый набор модулей, настройки подключения и разрешённые взаимодействия. Не требуется переносить во внешний контур все интеграционные возможности платформы только потому, что часть из них должна принимать запросы извне.
Состав интеграционных сервисов подстраивается под архитектуру и требования безопасности заказчика, а не наоборот.
Заменяемость и цена выхода
Ещё один неудобный вопрос: не меняет ли заказчик зависимость от собственного кода на зависимость от UniBPM? Ответ: Меняет. Использование платформы создаёт зависимость от её модели, контрактов и жизненного цикла.
Вопрос – насколько эта зависимость понятна и управляема.
UniBPM предоставляет:
- REST API с описанием OpenAPI,
- функции импорта/экспорта процессов и таблиц решений.
- модульную интеграционную платформу.
Это даёт технические точки для собственного интерфейса, дополнительных интеграций и переноса артефактов.
Есть возможность использовать вместо внутреннего процессного движка обычную Camunda 7 или Camunda 8.
О лицензировании
При внедрении стоит учитывать, что UniBPM – коммерческая платформа с возможностью использования в Community-режиме. Ограничения Community-версии – отсутствие Enterprise-поддержки и только одно рабочее пространство.
Что в итоге получает заказчик?
Главный эффект – не “мы стали быстрее рисовать BPMN”.
Это возможность не заказывать заново прикладную инфраструктуру под каждый следующий процесс: работу с заявками, задачами, формами, документами и доступом. Команда по-прежнему проектирует предметную область, описывает правила, реализует специфические интеграции и проверяет отказные сценарии. Но делает это на основе фундамента – общей платформы.
Окупится ли такой подход в конкретной компании? Предлагаем проверить это на пилотном проекте. Для пилота стоит взять один настоящий процесс: с пользователями, документами, интеграцией и неудобными исключениями. Зафиксировать, что удалось настроить, что пришлось написать и что потребуется сопровождать.
Затем повторить на следующем процессе – если не потребуется создавать почти всё с нуля, значит эффект от внедрения есть!
А где UniBPM будет лишним?
На наш взгляд, хороший кандидат – долгоживущий процесс, в котором участвуют люди и внешние системы, есть обсуждения, документы, согласования и требования к разграничению доступа. Плохой повод для внедрения – необходимость просто вызвать несколько микросервисов в нужном порядке или передать данные из системы A в системы B и C.
Другой случай: у компании уже есть зрелое приложение со своей предметной моделью, интерфейсом, документами и безопасностью. Возможно, ему действительно нужен только движок – не обязательно приносить вторую прикладную платформу лишь потому, что она умеет запускать BPMN. И наоборот, когда уже существующие решения не обеспечивают принцип “одного окна” – это повод задуматься о UniBPM.
В качестве послесловия
Создавая UniBPM, мы не пытались доказать, что BPM-движки устроены неправильно.
Движок прекрасно справляется с управлением процессом, но пользователям и бизнесу обычно требуется больше.
Мы попробовали собрать этот повторяющийся прикладной слой в продукт: отделить бизнес-объект от исполнения процесса, интеграции – от процессного ядра, а пользовательскую работу – от технических подробностей движка.
Это не отменяет архитектуру, анализ и разработку, но даёт шанс тратить их на особенности бизнеса, а не на очередную реализацию комментариев к заявке.
На наш взгляд, в этом и состоит смысл платформы: один раз решить повторяющиеся технические задачи и дальше вкладываться в бизнес-логику.